Todas las sesiones

Sesión 1 de 8

Fundamentos de IA, aprendizaje y responsabilidad docente

¿Cómo aprende una máquina y qué responsabilidad seguimos teniendo nosotros?

Qué es la IA, cómo aprende, laboratorios de aprendizaje supervisado y no supervisado, AI Act y el papel del docente.

Sesión 1 · 300 min

¿Cómo aprende una máquina y qué responsabilidad seguimos teniendo nosotros?

  1. 1 · Comprender
    ¿Qué es IA?

    Campo, historia, técnicas, límites.

  2. 2 · Experimentar
    ¿Cómo aprende?

    Supervisado y no supervisado.

  3. 3 · Datos
    ¿Qué ve?

    Solo las variables y ejemplos disponibles.

  4. 4 · Interpretar
    ¿Qué significa?

    Patrón no equivale a diagnóstico.

  5. 5 · Responsabilidad
    ¿Quién decide?

    El docente sigue contextualizando y validando.

0–10

Apertura · ¿Qué llamamos inteligencia artificial?

Objetivo: activar ideas previas y evitar que IA se reduzca a ChatGPT.

Calculadora

Reglas explícitas.

Filtro de spam

Puede usar modelos aprendidos.

Recomendador

Predicción/personalización.

Reconocimiento de imagen

Patrones visuales.

ChatGPT

IA generativa.

Regla SI/ENTONCES

Automatización; no necesariamente ML.
10–35

Teoría I · Qué es IA, historia y Test de Turing

Base: presentación habitual, con las correcciones técnicas validadas.

  1. 1950Turing
  2. 1956Dartmouth
  3. Sistemas expertos
  4. Machine Learning
  5. Deep Learning
  6. 2017–hoyTransformers / IA generativa
35–55

Teoría II · Aplicaciones, capacidades y tipos de IA

Objetivo: distinguir usos actuales de hipótesis sobre IA general/superinteligencia.

IA actual

Clasifica, recomienda, predice, reconoce, genera y automatiza tareas delimitadas.

AGI

Concepto discutido e hipotético de capacidad general comparable a la humana. No existe consenso sobre una prueba única para afirmar que se ha alcanzado.

ASI

Escenario hipotético/especulativo de capacidades intelectuales superiores a las humanas.

55–90

Teoría III · Machine Learning, redes neuronales, tipos de aprendizaje y datos

Objetivo: construir el vocabulario que después se experimentará en los dos laboratorios.

  1. Datos / ejemplos
  2. Entrenamiento
  3. Modelo
  4. Caso nuevo
  5. Predicción / salida
  6. Evaluación
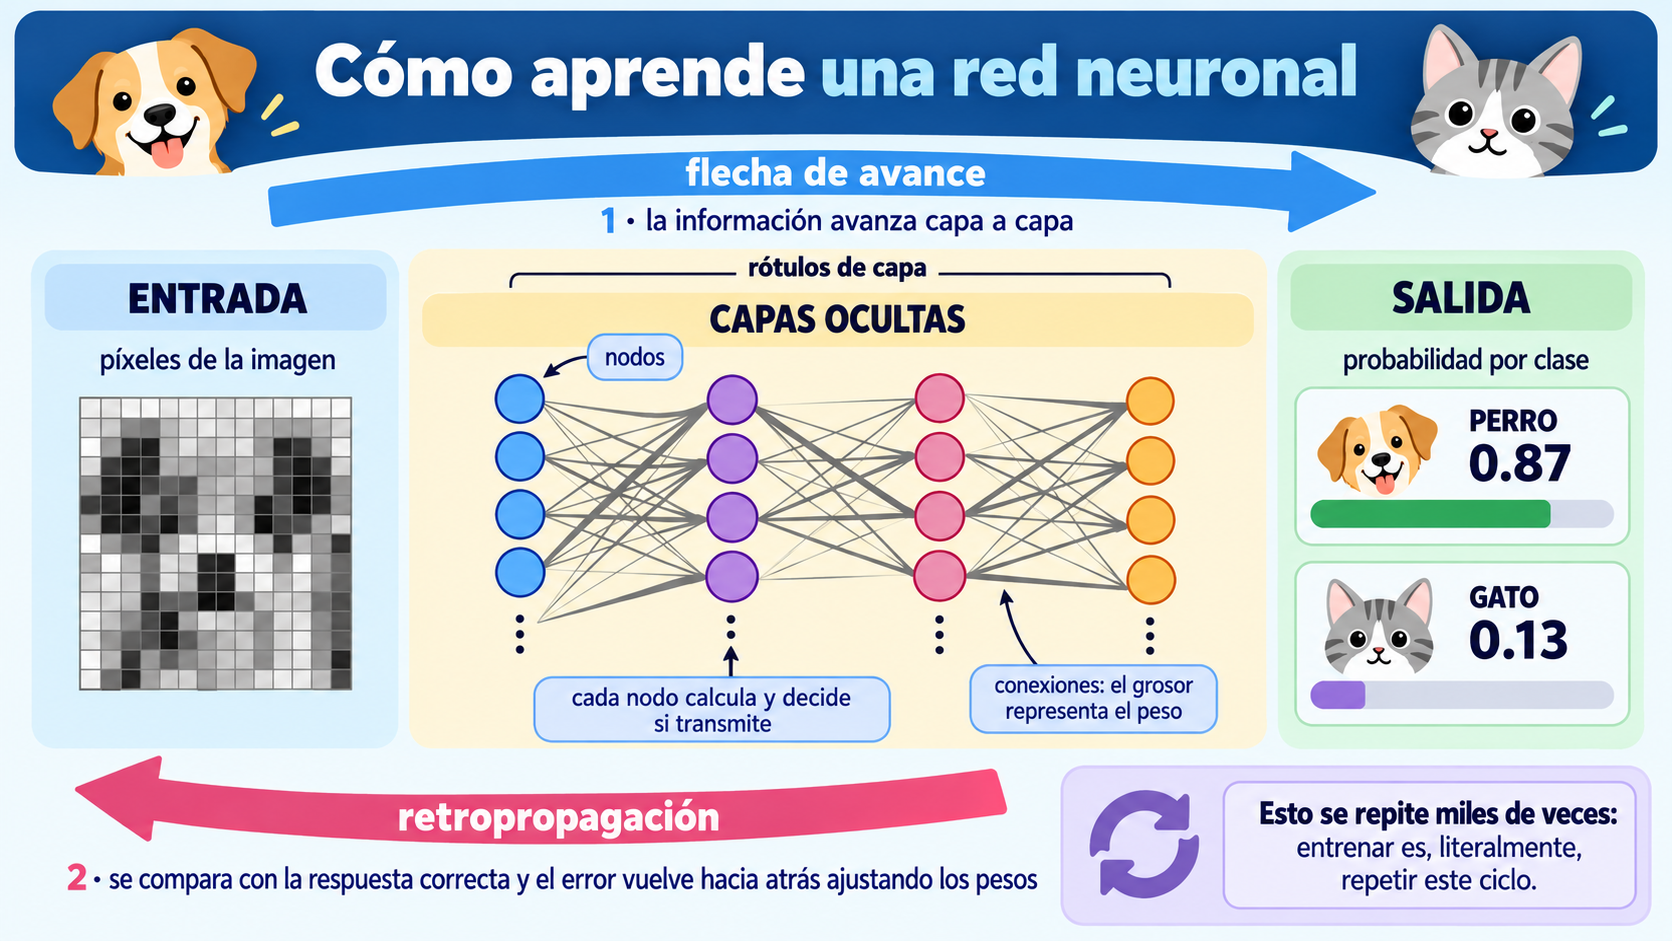
Infografía: cómo aprende una red neuronal. La información avanza de la capa de entrada (píxeles de la imagen) a las capas ocultas y a la salida con la probabilidad de cada clase; la retropropagación devuelve el error hacia atrás y ajusta los pesos.
Cómo aprende una red neuronal: la información avanza capa a capa y el error vuelve hacia atrás ajustando los pesos.

1 · Entrada

Los datos se convierten en números. Una imagen entra como valores de píxel, no como «un perro».

2 · Capas

pesos

Cada nodo recibe valores de la capa anterior, los multiplica por sus

y los suma. El grosor de las líneas de la infografía representa esos pesos.

3 · Activación

Una función decide si ese resultado pasa a la capa siguiente y con qué intensidad. Es lo que permite aprender relaciones que no son una simple línea recta.

4 · Salida

La última capa devuelve un número por clase. No es un veredicto: es un reparto de probabilidad.

5 · Retropropagación

entrenar

Se compara la salida con la respuesta correcta, se mide el error y se propaga hacia atrás ajustando los pesos. Repetido miles de veces, eso es

.

Supervisado

Ejemplos con etiqueta/resultado conocido.

No supervisado

Busca estructura o agrupaciones sin etiqueta objetivo.

Por refuerzo

Agente, entorno, acciones y recompensas.

Semi-supervisado

Combina pocos datos etiquetados con muchos sin etiquetar.

90–115

Descanso · 25 min

Al volver, la teoría se convierte en experiencia.

115–160

Laboratorio 1 · Aprendizaje supervisado · Perros y gatos

Actividad individual con Machine Learning for Kids. Vamos a entrenar nuestro primer modelo de Machine Learning: la máquina deberá aprender a distinguir entre imágenes de perros y de gatos a partir de ejemplos que nosotros mismos le proporcionaremos.

  1. IMÁGENESejemplos que damos
  2. ETIQUETASPERROS / GATOS
  3. ENTRENAR
  4. MODELO
  5. IMÁGENES NUEVASnunca vistas
  6. ERRORESanalizar
  7. REENTRENAR
Ejercicio · interactivo
0/5

Paso a paso · construir el modelo

Trabajo individual. No se utilizan fotografías de alumnado ni imágenes con personas identificables.

Proyecto de reconocimiento de imágenes creado

Dos etiquetas creadas: PERROS y GATOS

Ejemplos variados en ambas categorías (razas, posiciones, tamaños, colores, fondos)

Modelo entrenado

Probado con imágenes nuevas

Tus marcas y respuestas se guardan solo en este navegador.

Ejercicio · interactivo
0/6

Comprobación · ¿qué hace el modelo?

¿Reconoce correctamente perros?

¿Reconoce correctamente gatos?

¿En qué imágenes tiene más dudas?

¿Hay alguna imagen que clasifique incorrectamente?

Búsqueda deliberada de casos difíciles

Un perro parcialmente oculto, un gato de espaldas, dibujos, fondos poco habituales, animales pequeños dentro de la fotografía, etc.

Casos difíciles probados y qué respondió el modelo

Corregir y volver a entrenar

Analiza sus errores y añade nuevos ejemplos de entrenamiento que puedan ayudarle. Vuelve a entrenar y comprueba si mejora.

¿Qué ejemplos añadiste y por qué?

¿Mejoró tras reentrenar? ¿En qué exactamente?

Tus marcas y respuestas se guardan solo en este navegador.

Ejercicio · interactivo
0/7

Al terminar · preguntas de cierre

¿Qué eran los datos de entrenamiento en esta actividad?

¿Qué eran las etiquetas?

¿Qué significa entrenar el modelo?

¿Qué ocurrió cuando utilizaste imágenes nuevas?

Describe al menos un error cometido por tu modelo.

¿Por qué crees que se equivocó?

¿Qué hiciste para intentar mejorarlo?

¿Podemos afirmar que una máquina «entiende» qué es un perro o un gato porque los clasifique correctamente? Explica tu respuesta.

Tus marcas y respuestas se guardan solo en este navegador.

Función pedagógica: experimentar aprendizaje supervisado con dos clases y un ciclo completo de error → corrección → reentrenamiento. Herramientas externas: verificar acceso y cuentas antes de la sesión. Las imágenes se buscan en repositorios abiertos; no usar fotografías de alumnado.

160–205

Laboratorio 2 · Aprendizaje no supervisado con Orange

Objetivo: que vean cómo la máquina puede encontrar grupos sin etiquetas y, sobre todo, dónde termina el patrón y empieza la interpretación docente.

  1. FILE
  2. SELECT COLUMNS
  3. K-MEANS
  4. SCATTER PLOT
Ejercicio · interactivo
0/8

Paso a paso

¿Qué patrón observas?

¿Cómo llamarías intuitivamente a cada grupo?

Tus marcas y respuestas se guardan solo en este navegador.

Misma huella digital

Poca actividad en plataforma.

Contexto A

Trabaja offline y entra solo para entregar.

Contexto B

Tiene conectividad deficiente o realmente está desconectándose.

205–245

AI Act · ¿Dónde está la educación en el mapa de riesgo?

Objetivo: introducir regulación desde la responsabilidad que acaba de aparecer en Orange, no como un bloque jurídico aislado.

🔴 Inaceptable

Usos prohibidos. En educación: inferencia de emociones en instituciones educativas, salvo excepciones médicas o de seguridad.

🟠 Alto riesgo

Usos educativos concretos: acceso/admisión, evaluación de resultados de aprendizaje, determinación de nivel y vigilancia de conductas prohibidas durante exámenes.

🟡 Transparencia

Situaciones donde la persona debe saber que interactúa con IA o que está ante determinado contenido generado/manipulado.

🟢 Mínimo / nulo

Muchos usos ordinarios: brainstorming, apoyo a borradores, filtros de spam, etc. No elimina otras obligaciones aplicables.

¿En qué punto estamos? · 31 de agosto de 2026

  1. 01/08/2024entra en vigor
  2. 02/02/2025prohibiciones + alfabetización IA
  3. 02/08/2025gobernanza + GPAI
  4. 02/08/2026aplicación general + transparencia
  5. 02/12/2027alto riesgo Anexo III
  6. 02/08/2028alto riesgo Anexo I

[FUENTE EXTERNA VERIFICADA 31/08/2026] · Reglamento (UE) 2024/1689 modificado por Reglamento (UE) 2026/1744.

245–290

Debate final · El lado oscuro y ¿hasta dónde delegarías?

Actividad colaborativa para integrar técnica, ética, datos, AI Act y criterio docente. Diez minutos de detonante y treinta y cinco de trabajo sobre casos.

Detonante · quién etiquetó los datos

Esta mañana, en el Laboratorio 1, hemos etiquetado imágenes de perros y gatos durante media hora. Ese mismo gesto, multiplicado por miles de horas y con contenido muy distinto, es lo que sostiene los modelos comerciales que usamos.

Detonante: 10 min máximo. No proyectar el artículo de TIME. Enlazar explícitamente con el Laboratorio 1 («lo que hicisteis esta mañana») antes de dar las cifras: el efecto depende de ese orden. El anexo de conceptos éticos queda al final de la sesión como material de consulta, no se lee en clase.

Seis casos sobre la mesa

Caso A

Una IA propone cinco actividades a partir de un currículo público. El docente elige y adapta.

Caso B

Un chatbot tutor conversa directamente con alumnado y responde dudas.

Caso C

Un sistema puntúa producciones y decide automáticamente qué nivel puede cursar cada persona.

Caso D

Una cámara intenta inferir aburrimiento, atención o emoción del alumnado durante la clase.

Caso E

Un dashboard agrupa patrones de actividad y muestra al docente posibles casos a revisar.

Caso F

Un sistema monitoriza un examen para detectar conductas prohibidas.

Ejercicio · interactivo
0/5

Para cada caso

¿Qué color del semáforo propondrías y por qué?

¿Qué datos utiliza o podría utilizar?

¿Qué daño podría producir un error?

¿Qué debería seguir bajo decisión humana?

¿Qué tendría que poder explicarse al alumnado?

Tus marcas y respuestas se guardan solo en este navegador.

290–300

Cierre · Lo que sabemos hoy y lo que viene mañana

Recuperación activa + puente narrativo a la sesión 2.

Ejercicio · interactivo
0/3

¿Por qué un patrón no es un diagnóstico?

¿Qué responsabilidad no desaparece porque exista una alerta o predicción?

Tus marcas y respuestas se guardan solo en este navegador.

  1. HOYdatos → modelos → patrones → responsabilidad
  2. MAÑANAProcesamiento de Lenguaje Natural → LLM → prompting
Anexo

Anexo · Conceptos éticos para trabajar con IA

Material de consulta, no de aula. Ocho decisiones que el profesorado toma —o deja de tomar— cada vez que introduce una herramienta de IA. Cada una viene con la pregunta que hay que poder responder.

Pregunta:

1 · Sesgo y representatividad

Un modelo reproduce lo que hay en sus datos, incluidas las ausencias. En 2018 Amazon descartó una herramienta interna de cribado de currículums porque penalizaba los CV que contenían la palabra «women's».

¿a quién representa mal este sistema, y cómo lo sabría si no lo busco?

quien responde es el docente

2 · Responsabilidad

La responsabilidad no se delega en la herramienta. Si un sistema propone una nota, una alerta o un itinerario y el docente lo firma, .

Pregunta: si esta decisión sale mal, ¿quién da la cara ante la familia?

Pregunta:

3 · Equidad del resultado

Un sistema que decide qué nivel puede cursar cada persona no es un asistente: reparte oportunidades. El caso C del debate es exactamente esto, en versión escolar del ejemplo de justicia penal.

¿este uso reparte oportunidades? Si la respuesta es sí, sube la exigencia de todo lo demás.

Pregunta:

4 · Privacidad y datos personales

Los datos de menores tienen protección reforzada. Nombres, notas, informes, incidencias y fotografías de alumnado no se pegan en un chat.

lo que estoy a punto de escribir en el prompt, ¿podría enseñárselo a la familia y a la dirección del centro?

Un modelo de lenguaje puede redactar una justificación convincente de una decisión que no es la que realmente tomó.

5 · Transparencia y explicabilidad

Explicabilidad no es obtener una explicación plausible. Pedirle que «explique por qué» no equivale a auditarlo.

Pregunta: ¿puedo explicar esta decisión al alumnado sin apoyarme en lo que el propio sistema dice de sí mismo?

Pregunta:

6 · Autoría y evaluación

Afecta a las dos direcciones: lo que produce el alumnado con IA y lo que produce el profesorado con IA. Los detectores de texto generado tienen tasas de error altas y fallan más con quien escribe en una lengua que no es la suya.

¿qué estoy evaluando exactamente, y sigue siendo evaluable así?

Pregunta:

7 · Trabajo humano oculto

Detrás de cada modelo hay personas etiquetando datos, muchas veces en condiciones que la propia industria no muestra. El caso TIME del debate final es el ejemplo documentado.

¿quién etiquetó estos datos y en qué condiciones? Que no haya respuesta pública también dice algo.

Pregunta:

8 · Coste ambiental y acceso

Entrenar y consultar modelos consume energía y agua. Y las versiones útiles suelen ser de pago: si una actividad exige la versión de pago, estoy repartiendo desigualdad dentro del aula. Enlaza con la brecha digital ya vista en «Desafíos».

¿esta actividad se puede hacer sin que nadie pague?

Ejercicio · interactivo
0/1

Antes de meter una herramienta de IA en clase

Seis comprobaciones. Si alguna se queda sin respuesta, la herramienta todavía no entra.

Sé qué datos entran y he comprobado que no hay datos personales de alumnado

Sé si lo que escribo se almacena o se usa para entrenar

La decisión final sigue siendo mía y puedo explicarla sin citar al sistema

He pensado a quién puede perjudicar un error y cuánto

El alumnado sabe que hay una IA implicada y en qué parte

La actividad es viable sin versión de pago

¿Qué herramienta tengo en mente y qué casilla se me ha quedado sin marcar?

Tus marcas y respuestas se guardan solo en este navegador.

¿Dudas con esta sesión?

El tutor del curso conoce este contenido y puede ayudarte a adaptarlo a tu materia.

Preguntar al tutor